打造開放兼容的AI軟件新生態 人工智能應用軟件開發的新范式
引言
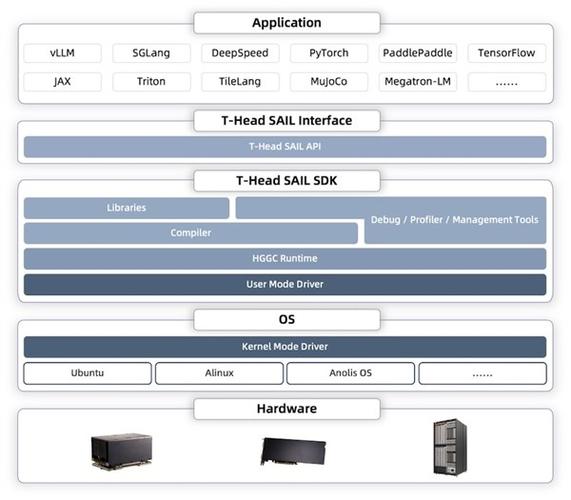
人工智能(AI)正以前所未有的速度重塑各行各業,而AI應用軟件作為技術落地的關鍵載體,其開發模式與生態構建方式直接決定了AI價值的釋放程度。過去,AI軟件開發往往依賴封閉的技術棧和孤立的平臺,導致重復造輪、協同困難、創新受限。如今,打造開放兼容的AI軟件新生態已成為產業共識,它為人工智能應用軟件開發帶來了全新的范式。
一、為什么需要開放兼容的AI軟件新生態?
- 技術碎片化倒逼開放:深度學習框架、模型格式、硬件加速器百花齊放,若每個項目都從頭適配,成本極高。開放兼容的生態能讓不同組件像積木一樣組合。
- 降低開發門檻:中小企業和個人開發者難以承擔全棧自研。開放生態提供預訓練模型、工具鏈和云服務,讓AI應用開發從“手工作坊”走向“工業化”。
- 避免廠商鎖定:封閉生態易導致用戶被單一供應商綁架。開放標準(如ONNX、MLIR)和開源項目確保了跨平臺的可移植性。
- 加速創新迭代:社區共享代碼、數據集和最佳實踐,使新算法、新應用能迅速傳播和優化。
二、開放兼容ai軟件新生態的核心要素
一個健康的AI軟件生態應具備以下特征:
- 開放標準與接口:如ONNX(開放神經網絡交換格式)、OpenVINO、PMML等,實現模型跨框架、跨硬件部署。
- 開源框架與工具鏈:TensorFlow、PyTorch、MindSpore、PaddlePaddle等相互借鑒,并通過適配層互通。
- 模塊化與可組合性:數據預處理、特征工程、模型訓練、推理、監控等環節均可替換。
- 跨平臺運行能力:支持云、邊、端多種部署環境,屏蔽底層硬件差異。
- 社區治理與協作:基金會(如LF AI & Data)、開源社區共同維護核心項目。
- 互操作性與兼容性:能與現有IT系統(數據庫、消息隊列、微服務)無縫集成。
三、人工智能應用軟件開發的關鍵實踐
在開放兼容生態下,AI應用軟件開發需遵循以下實踐:
- 以模型為中心轉向以數據與流程為中心:利用開放格式管理模型,并將AI開發融入CI/CD/CT(持續集成/持續交付/持續訓練)流水線。
- 采用MLOps:通過開源工具(MLflow、Kubeflow、Airflow)實現實驗跟蹤、模型注冊、自動化部署與監控。
- 優先使用開放模型與數據集:如Hugging Face上的預訓練模型,減少重復訓練,加速產品化。
- 設計可移植的推理引擎:采用ONNX Runtime、TVM、OpenVINO等,確保模型在不同硬件上高效運行。
- 注重隱私與安全:借助聯邦學習、差分隱私等開源框架,在開放的同時保護數據。
- 構建領域特定語言(DSL)與低代碼平臺:讓業務人員也能參與AI應用構建,擴大生態參與者。
四、挑戰與應對
- 兼容性成本:不同框架版本、算子語義差異可能導致移植失敗。應對:加強標準測試套件(如ONNX Backend Test)。
- 性能損耗:跨框架轉換可能損失性能。應對:使用圖優化、算子融合及硬件專用加速庫。
- 社區治理難題:開源項目可能分裂或停滯。應對:引入中立基金會,建立貢獻者協議和路線圖。
- 商業與開源的平衡:企業擔心開源核心削弱競爭力。應對:采用開放核心(Open Core)模式,基礎開源、高級功能商業授權。
五、未來展望
隨著大模型和生成式AI的爆發,AI軟件生態將更加依賴開放兼容。未來的AI應用開發可能呈現以下趨勢:
- 模型即服務(MaaS)與開放模型市場:開發者可像選云服務一樣調用各類模型。
- AI編譯與統一中間表示:MLIR等將打通從訓練到部署的全鏈路。
- 邊緣AI與云邊協同:開放生態使得模型能自動分割、協同推理。
- 聯邦生態與數據空間:在保護隱私前提下實現跨機構模型共享。
##
打造開放兼容的AI軟件新生態,不是簡單的技術選型,而是一種戰略選擇。它要求開發者、企業和社區共同推動標準、共享成果、協同創新。只有這樣,人工智能應用軟件開發才能擺脫重復勞動,邁向高效、靈活、可持續的未來。讓我們擁抱開放,兼容并蓄,共筑AI軟件的新生態。
最新產品
騰訊云助力2019四川省職業院校技能大賽“人工智能技術與應用”賽項 產教融合培育AI應用開發新力量
人工智能時代軟件工程學科系列教材建設探索——以董天陽、王婷等編著的高等院校教材為例
大模型驅動的研發新范式 軟件工程的AI革命
2025年軟件信息行業人工智能技術應用與軟件開發趨勢研究報告
人工智能服務系統如何工作?解析其技術架構與行業應用邏輯
國家人工智能產業創新應用先導區落地銀川 開啟人工智能應用軟件開發新篇章
未來10-20年,開發崗程序員會被AI取代嗎?——兼談人工智能應用軟件開發
泉州市重磅出臺人工智能產業發展方案,最高獎勵1000萬元助力應用軟件開發
解鎖未來 從Python趣味編程到人工智能應用開發——青少年編程入門指南
融合與躍遷 從Solidity到人工智能——科學出版社技術教材的多元開發世界